| 项目 |
内容 |
| 课标主题 |
选择性必修 · 概率与统计 · 成对数据的统计分析 |
| 人教 A 版 |
选择性必修第三册 第八章 8.1–8.3 |
| 考试地位 |
常考。解答题常考“求经验回归方程并预测”或“列联表加独立性检验”,常和分布列一起考;选择题、填空题常考相关系数的性质、回归直线过样本中心、残差 |
| 前置知识 |
第 20 章统计(平均数、方差);第 21 章事件的独立性;第 28 章直线的方程 |
前面的统计只研究一个变量,这一章研究两个变量之间有没有关系、有多强、能不能用一个推算另一个。两个变量都是数值时,用相关系数和回归方程;两个变量都是类别(如“是否近视”“是否经常用手机”)时,用列联表和独立性检验。题目计算量大但套路固定,丢分主要丢在三处:公式里的和式算错、把相关当成因果、独立性检验的结论写错了口径。
| 知识点 |
一句话 |
考试中 |
| 38.2 成对数据的相关性与样本相关系数 |
散点图看方向,样本相关系数 r 的正负看方向,$ |
r |
| 38.3 一元线性回归模型与最小二乘法 |
让残差平方和最小,得到 y^=b^x+a^,它一定过样本中心 (xˉ,yˉ) |
常考,解答题求回归方程并预测,有时要先换元 |
| 38.4 列联表与独立性检验 |
把两个分类变量的计数排成 2×2 表,算 χ2,和临界值比较后下结论 |
常考,解答题第一问的高频题型 |
成对数据:对同一批对象同时观测两个变量,得到 n 组数 (x1,y1),(x2,y2),…,(xn,yn)。比如 5 个月的广告费和销售额,每个月一对。
相关关系:两个变量有关系,但一个变量的值不能完全确定另一个变量的值。身高和体重就是相关关系:身高高的人一般更重,但同样身高的人体重各不相同。它和函数关系不同,函数关系里 x 一定,y 就唯一确定。
散点图:把每对数据画成平面上的一个点 (xi,yi)。从散点图上看两件事:
- 方向:y 随 x 增大而大体增大,叫正相关;大体减小,叫负相关。
- 形状:点大致落在一条直线附近,叫线性相关;落在一条曲线附近,叫非线性相关;看不出趋势,叫不相关。
样本相关系数:用一个数刻画线性相关的方向和强弱。记 xˉ、yˉ 为两组数据的平均数,
r=∑i=1n(xi−xˉ)2∑i=1n(yi−yˉ)2∑i=1n(xi−xˉ)(yi−yˉ).
题目给的常是各种和,这时用等价写法更快(推导见“证明”):
r=∑i=1nxi2−nxˉ2∑i=1nyi2−nyˉ2∑i=1nxiyi−nxˉyˉ.
r 的含义:
| r 的情况 |
含义 |
| r>0 |
正相关 |
| r<0 |
负相关 |
| $ |
r |
| $ |
r |
| $ |
r |
r 的取值范围是 −1≤r≤1。
- 题目给出散点图,问正相关还是负相关、哪组相关性更强:看点的走向和贴近直线的程度。
- 题目给出成对数据或各种和,要求算相关系数、判断线性相关强弱:代公式算 r,看 ∣r∣ 是否接近 1。
- 题目问数据变换(换单位、乘负数、加点、去掉异常点)后 r 怎么变,或比较几组的 r:用 r 的性质,不用重算。
- r 只衡量线性相关。r≈0 只说明没有线性关系,不说明没有关系:上图 ④ 的点排成抛物线,关系很明显,r 却等于 0。
- 比较相关的强弱看 ∣r∣,不看 r。r=−0.95 比 r=0.90 线性相关更强。
- 教材没有规定”∣r∣ 大于多少算强相关”。题目若给出标准(如”∣r∣>0.75 认为线性相关很强”),按题目的标准判断。
- 相关不等于因果。冰淇淋销量和溺水人数正相关,原因是天热,两者之间没有因果关系。
- 分母要求 xi 不全相等、yi 不全相等,否则 r 没有意义(散点排成一条竖线或横线)。
结论 1:分子、分母的两种写法相等。
把 (xi−xˉ)(yi−yˉ) 展开再求和:
i=1∑n(xi−xˉ)(yi−yˉ)=i=1∑nxiyi−yˉi=1∑nxi−xˉi=1∑nyi+nxˉyˉ.
因为 ∑xi=nxˉ,∑yi=nyˉ,右边等于 ∑xiyi−nxˉyˉ−nxˉyˉ+nxˉyˉ=∑xiyi−nxˉyˉ。令 yi=xi,就得到 ∑(xi−xˉ)2=∑xi2−nxˉ2。
结论 2:∣r∣≤1,且 ∣r∣=1 当且仅当所有点在一条直线上。
记 ui=xi−xˉ,vi=yi−yˉ,要证 (∑uivi)2≤∑ui2⋅∑vi2。
对任意实数 t,构造
f(t)=i=1∑n(tui−vi)2=(∑ui2)t2−2(∑uivi)t+∑vi2.
(关键一步:f(t) 是若干个平方的和,所以对一切 t 都有 f(t)≥0;它又是 t 的二次函数,二次项系数 ∑ui2>0,开口向上且不取负值,判别式只能 ≤0。)
Δ=4(∑uivi)2−4∑ui2∑vi2≤0,
即 (∑uivi)2≤∑ui2∑vi2,两边开方得 ∣r∣≤1。
等号成立 ⟺Δ=0⟺ 存在 t0 使 f(t0)=0⟺ 每一项 t0ui−vi=0,即 yi−yˉ=t0(xi−xˉ) 对所有 i 成立,也就是所有点 (xi,yi) 都在过 (xˉ,yˉ)、斜率为 t0 的直线上。
这个证明用的是二次函数的判别式(第 4 章),和柯西不等式的证明是同一个想法。
例 1 (场景:由散点图判断相关性)观察上面四幅散点图,回答:(1)哪幅是正相关,哪幅是负相关?(2)哪两幅的样本相关系数最接近 0?(3)第 ④ 幅的 x 和 y 有没有关系?
解:
(1)① 的点从左下到右上,y 随 x 增大而增大,是正相关;② 的点从左上到右下,是负相关。两幅的点都紧贴一条直线,线性相关都很强(算出来 r 分别约为 0.99 和 −0.99)。
(2)③ 和 ④。③ 的点散乱,没有趋势,r≈−0.07。④ 的点左半边上升、右半边下降,正、负两部分抵消,r=0。
(3)有关系,而且很强:点几乎落在一条抛物线上。r=0 只说明没有线性关系。
容易卡在:看到 r 接近 0 就说“两个变量没有关系”。
例 2 (场景:计算样本相关系数)某商店 5 个月的广告费 x(万元)和销售额增加量 y(万元)如下,求样本相关系数 r,并判断线性相关的强弱。
| x |
1 |
2 |
3 |
4 |
5 |
| y |
2 |
3 |
4 |
6 |
10 |
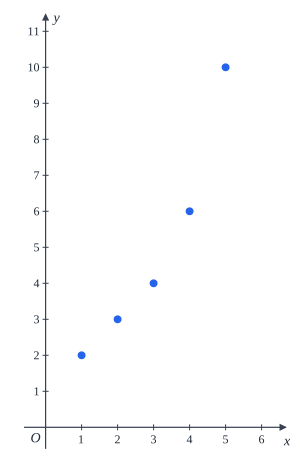
解:xˉ=51+2+3+4+5=3,yˉ=52+3+4+6+10=5。列表算离差:
| xi−xˉ |
−2 |
−1 |
0 |
1 |
2 |
| yi−yˉ |
−3 |
−2 |
−1 |
1 |
5 |
| 乘积 |
6 |
2 |
0 |
1 |
10 |
∑(xi−xˉ)(yi−yˉ)=6+2+0+1+10=19,
∑(xi−xˉ)2=4+1+0+1+4=10,∑(yi−yˉ)2=9+4+1+1+25=40.
r=10×4019=40019=2019=0.95.
r=0.95,接近 1,广告费和销售额增加量正相关,线性相关很强。
另一种解法:用和式写法。∑xiyi=2+6+12+24+50=94,∑xi2=55,∑yi2=4+9+16+36+100=165,
r=55−5×32165−5×5294−5×3×5=104019=0.95.
数据少、平均数是整数时,离差法数字小、不容易错;题目直接给出 ∑xiyi、∑xi2 这类和时,用和式写法省去列表。
容易卡在:和式写法里漏乘 n,写成 ∑xiyi−xˉyˉ。
例 3 (场景:数据变换后 r 怎么变)沿用例 2 的数据(r=0.95),判断下列说法是否正确:
(1)把广告费的单位从万元改成元,r 不变;
(2)令 y′=−2y+3,则 x 和 y′ 的样本相关系数为 −0.95;
(3)增加一个样本点 (3,5) 后,r 变大;
(4)另有一组数据的样本相关系数为 −0.97,它的线性相关比例 2 弱。
解:
(1)正确。换单位就是 x′=10000x,每个离差都乘 10000,分子、分母同乘 10000,r 不变。
(2)正确。y′−yˉ′=−2(y−yˉ),分子乘 −2,分母里 ∑(y′−yˉ′)2 乘 ∣−2∣=2,所以 r 变号,绝对值不变,为 −0.95。
(3)错误。(3,5) 恰好是样本中心 (xˉ,yˉ)。加进去后平均数仍是 3 和 5,新点的两个离差都是 0,三个和式都不变,r 仍是 0.95。
(4)错误。比较强弱看绝对值,0.97>0.95,这组的线性相关更强。
容易卡在:(3)以为加点一定改变 r;(4)只比较带符号的大小。
- 线性变换不改变 ∣r∣:若 x′=kx+m(k=0),则 x′ 与 y 的相关系数为 r(k>0)或 −r(k<0)。推导:每个离差乘 k,分子乘 k,分母乘 ∣k∣。对 y 做变换同理。
- 交换 x 和 y,r 不变:公式关于 x、y 对称。
- r 与回归系数同号:b^=r⋅∑(xi−xˉ)2∑(yi−yˉ)2,根号前的式子为正,所以 b^ 与 r 符号相同。由 38.3 节 b^ 的公式和本节 r 的公式相除即得。
- 所有点在斜率为正(负)的直线上 ⟺r=1(r=−1),推导见本节“证明”结论 2。
- 错在哪:r≈0,结论写”x 与 y 没有关系”。
为什么错:r 只刻画线性关系,二次关系、周期关系的 r 也可能接近 0。
正确做法:写”x 与 y 的线性相关性很弱”,必要时看散点图。
- 错在哪:r1=0.9,r2=−0.95,认为第一组相关性更强。
为什么错:r 的正负只表示方向,强弱看 ∣r∣。
正确做法:比较 ∣r1∣=0.9<∣r2∣=0.95,第二组更强。
- 错在哪:由“两个变量强相关”推出“一个导致另一个”。
为什么错:相关可能来自第三个因素,也可能是巧合。
正确做法:相关系数只说明数据上一起变化,因果要靠实验或专业知识判断。
把 x 的离差 (u1,…,un) 和 y 的离差 (v1,…,vn) 看成两个向量,r 的公式就是“数量积除以两个模的乘积”,也就是这两个向量夹角的余弦(第 15 章平面向量夹角公式推广到 n 维)。夹角为 0 时 r=1,两组数据“步调完全一致”;夹角为 90∘ 时 r=0,“互不相干”;夹角为 180∘ 时 r=−1,“步调完全相反”。所以 ∣r∣ 不会超过 1,余弦本来就在 [−1,1] 里。
一句话记法:正负看方向,绝对值看贴不贴直线。
- 前置:第 20 章样本的数字特征,r 的分母就是 n 倍方差开方后的乘积。
- 前置:第 4 章二次函数,∣r∣≤1 的证明用到“恒非负的二次函数判别式 ≤0”。
- 后续:38.3 一元线性回归,先用 r 判断线性相关够强,再建立回归方程;b^ 与 r 同号。
- 常一起考:第 15 章平面向量数量积,r 可以看作离差向量夹角的余弦。
一元线性回归模型:y 的值由 x 决定一部分,剩下的是随机误差。写成
Y=bx+a+e,E(e)=0,D(e)=σ2.
x 叫解释变量(自变量),Y 叫响应变量(因变量),e 叫随机误差,a、b 是未知参数。E(e)=0 表示误差平均来说不偏高也不偏低。
最小二乘法:用样本数据估计 a、b。对任一条直线 y=bx+a,第 i 个点的竖直偏差是 yi−(bxi+a)。选 a、b 使偏差的平方和
Q(a,b)=i=1∑n(yi−bxi−a)2
最小,得到
b^=∑i=1n(xi−xˉ)2∑i=1n(xi−xˉ)(yi−yˉ)=∑i=1nxi2−nxˉ2∑i=1nxiyi−nxˉyˉ,a^=yˉ−b^xˉ.
直线 y^=b^x+a^ 叫经验回归直线,这个式子叫经验回归方程(旧教材叫“回归直线方程”)。y^ 上的帽子表示“估计值”。
残差:观测值减预测值,e^i=yi−y^i。以 x 为横轴、残差为纵轴画的图叫残差图。残差点在横轴上下随机、均匀地分布在一条窄带里,说明模型合适;呈现明显的规律(如 U 形),说明直线模型不够好。
决定系数:
R2=1−∑i=1n(yi−yˉ)2∑i=1n(yi−y^i)2.
分子是残差平方和,分母是 y 本身的波动。R2 在 0 和 1 之间,越接近 1,模型能解释的波动越多,拟合效果越好。比较两个模型时,选 R2 大的(等价于残差平方和小的)。
非线性回归:散点呈曲线时,先换元把它变成线性:
| 模型 |
换元 |
变成 |
| y=c⋅edx |
z=lny |
z=dx+lnc |
| y=a+bx2 |
t=x2 |
y=a+bt |
| y=a+xb |
t=x1 |
y=a+bt |
| y=a+blnx |
t=lnx |
y=a+bt |
对新变量用最小二乘法,再换回去。

- 给出成对数据或各种和,要求经验回归方程并预测:先算 xˉ、yˉ,再算 b^、a^,代入求 y^。
- 给出回归方程但数据表里缺一个数,或方程里缺一个系数:用“回归直线过样本中心 (xˉ,yˉ)“列方程。
- 题目问某个点的残差、问哪个模型拟合得好、给出残差图让你判断:算残差、残差平方和或 R2,看残差图的形状。
- 散点图呈曲线,或题目给出 y=c⋅edx、y=a+xb 这类模型:先换元化成线性,再用最小二乘法。
- 求 a^ 必须用 a^=yˉ−b^xˉ,先算 b^ 再算 a^,顺序不能反。
- 回归方程算出的是估计值,预测结论要写“约为”“预计为”,不能写成确定值。
- 预测只在数据范围附近可靠。用 5 岁到 10 岁儿童的身高数据去预测 40 岁的身高,结果没有意义。
- 回归方程是用 x 预测 y 的。反过来用 y 预测 x,要以 y 为自变量重新求,不能直接解方程。
- 残差是“观测值减预测值”,yi−y^i,顺序不能反。
- 非线性回归换元后,回归方程是关于新变量的,最后要换回原变量。
结论:使 Q(a,b)=∑(yi−bxi−a)2 最小的 a、b 是 b^=∑(xi−xˉ)2∑(xi−xˉ)(yi−yˉ),a^=yˉ−b^xˉ。
把每一项拆成两部分:
yi−bxi−a=[(yi−yˉ)−b(xi−xˉ)]+(yˉ−bxˉ−a).
记方括号里的式子为 wi,第二部分 m=yˉ−bxˉ−a 和 i 无关。平方再求和:
Q(a,b)=i=1∑nwi2+2mi=1∑nwi+nm2.
(关键一步:∑wi=∑(yi−yˉ)−b∑(xi−xˉ)=0−0=0,因为离差之和为 0。交叉项消失,Q 分成了只和 b 有关的一块与含 a 的一块。)
Q(a,b)=i=1∑n[(yi−yˉ)−b(xi−xˉ)]2+n(yˉ−bxˉ−a)2.
第二项 ≥0,取 a=yˉ−bxˉ 时为 0,这时最小。
第一项展开,记 Sxx=∑(xi−xˉ)2,Sxy=∑(xi−xˉ)(yi−yˉ),Syy=∑(yi−yˉ)2:
∑[(yi−yˉ)−b(xi−xˉ)]2=Sxxb2−2Sxyb+Syy.
这是 b 的二次函数,开口向上,在 b=SxxSxy 处最小(第 4 章二次函数的最值)。两块同时取最小,得到 b^=SxxSxy,a^=yˉ−b^xˉ。
例 1 (场景:求经验回归方程并预测)某市 2021 年到 2025 年的新能源汽车充电桩数量 y(千个)如下,年份代码 x 取 1 到 5。已知 ∑xiyi=107,∑xi2=55。求 y 关于 x 的经验回归方程,并预测 2026 年的充电桩数量。
| 年份 |
2021 |
2022 |
2023 |
2024 |
2025 |
| x |
1 |
2 |
3 |
4 |
5 |
| y |
3 |
4 |
6 |
7 |
10 |
解:xˉ=3,yˉ=53+4+6+7+10=6。
b^=∑xi2−5xˉ2∑xiyi−5xˉyˉ=55−5×9107−5×3×6=1017=1.7,
a^=yˉ−b^xˉ=6−1.7×3=0.9.
经验回归方程为 y^=1.7x+0.9。2026 年对应 x=6,y^=1.7×6+0.9=11.1,预计 2026 年约有 11.1 千个充电桩。
另一种解法:用离差算。xi−xˉ 依次为 −2,−1,0,1,2,yi−yˉ 依次为 −3,−2,0,1,4,乘积之和 6+2+0+1+8=17,∑(xi−xˉ)2=10,同样得 b^=1.7。题目给了 ∑xiyi 时用和式写法最快;题目只给原始数据、而 x 是 1 到 5 这种对称的年份代码时,离差都是小整数,离差法更不容易算错。
容易卡在:年份直接用 2021、2022 代入,数字太大;题目规定了年份代码就用代码,预测时也要把 2026 换成 6。
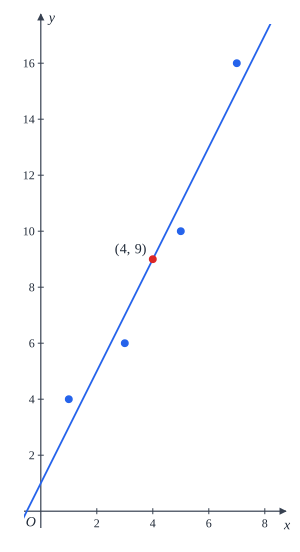
例 2 (场景:利用样本中心求未知量)某种商品的价格指数 x 和销量指数 y 的数据如下,其中 m 被污损。已知 y 关于 x 的经验回归方程为 y^=2x+1,求 m。
| x |
1 |
3 |
4 |
5 |
7 |
| y |
4 |
6 |
m |
10 |
16 |
解:xˉ=51+3+4+5+7=4。经验回归直线过样本中心,所以
yˉ=2×4+1=9.
于是 4+6+m+10+16=5×9=45,m=9。
容易卡在:想先用最小二乘公式求 b^,但 m 未知算不出来。题目已经给了方程,只需要“过样本中心”这一条。
例 3 (场景:残差分析与 R2 比较模型)沿用 38.2 节例 2 的数据(x:1, 2, 3, 4, 5;y:2, 3, 4, 6, 10)。
(1)求经验回归方程(模型①)和各点的残差;
(2)求模型①的 R2;
(3)另一个模型② y^=0.32x2+1.44(系数已四舍五入)的残差平方和约为 0.87,哪个模型拟合效果更好?
解:
(1)由 38.2 节例 2,xˉ=3,yˉ=5,∑(xi−xˉ)(yi−yˉ)=19,∑(xi−xˉ)2=10。所以 b^=1.9,a^=5−1.9×3=−0.7,模型①为 y^=1.9x−0.7。
| xi |
1 |
2 |
3 |
4 |
5 |
| yi |
2 |
3 |
4 |
6 |
10 |
| y^i |
1.2 |
3.1 |
5.0 |
6.9 |
8.8 |
| 残差 e^i=yi−y^i |
0.8 |
−0.1 |
−1.0 |
−0.9 |
1.2 |
(2)残差平方和 =0.64+0.01+1+0.81+1.44=3.9。由 38.2 节例 2,∑(yi−yˉ)2=40。
R2=1−403.9=0.9025.
(3)模型②的 R2=1−400.87≈0.978>0.9025,模型②拟合效果更好。
从残差图也能看出来:模型①的残差两头正、中间负,排成一个 U 形,说明数据有向上弯的趋势,直线没有抓住。
容易卡在:残差写成 y^i−yi,符号全反;R2 的分母用了残差平方和以外的错数。
例 4 (场景:非线性回归换元)某种细菌培养 x 小时后的数量 y(百个)如下。散点图呈指数增长,用 y=c⋅edx 拟合。令 z=lny,已算得 z 的值和 ∑(xi−xˉ)(zi−zˉ)=5.0。求 y 关于 x 的经验回归方程,并预测 x=6 时的数量(e3.5≈33.1)。
| x |
1 |
2 |
3 |
4 |
5 |
| y |
2.5 |
5.0 |
8.2 |
11.0 |
20.1 |
| z=lny |
0.9 |
1.6 |
2.1 |
2.4 |
3.0 |
解:对 y=c⋅edx 两边取自然对数:lny=dx+lnc,即 z=dx+lnc,z 与 x 是线性关系。
xˉ=3,zˉ=50.9+1.6+2.1+2.4+3.0=2.0,∑(xi−xˉ)2=10。
d^=105.0=0.5,lnc=zˉ−d^xˉ=2.0−0.5×3=0.5.
所以 z^=0.5x+0.5,换回原变量:y^=e0.5x+0.5。x=6 时 y^=e3.5≈33.1,预计约 3310 个。
容易卡在:求出 z^=0.5x+0.5 就停,忘了换回 y;或者把截距 0.5 当成 c,其实 lnc=0.5,c=e0.5≈1.65。
- 经验回归直线过样本中心 (xˉ,yˉ):由 a^=yˉ−b^xˉ 移项得 yˉ=b^xˉ+a^。
- 残差之和为 0:∑(yi−y^i)=∑yi−b^∑xi−na^=n(yˉ−b^xˉ−a^)=0。
- b^ 与 r 的关系:b^=rSxxSyy,两者同号。把 b^=SxxSxy 和 r=SxxSyySxy 相除即得。
- 一元线性回归中 R2=r2:把 y^i−yˉ=b^(xi−xˉ) 代入,残差平方和 =∑[(yi−yˉ)−b^(xi−xˉ)]2=Syy−2b^Sxy+b^2Sxx=Syy−SxxSxy2,于是 R2=SxxSyySxy2=r2。例 3 中 R2=0.9025=0.952,正好验证。
- b^ 的含义:x 每增加 1 个单位,y 平均增加 b^ 个单位(b^<0 时是平均减少)。解答题常要求解释这一点。
- 错在哪:先算 a^,或用 a^=xˉ−b^yˉ。
为什么错:公式是从 yˉ=b^xˉ+a^ 来的,x、y 不能互换。
正确做法:记“直线过 (xˉ,yˉ)”,由它反推 a^=yˉ−b^xˉ。
- 错在哪:预测结果写“2026 年的充电桩数量是 11.1 千个”。
为什么错:回归方程给的是估计值,实际值还受随机误差影响。
正确做法:写“预计约为 11.1 千个”。
- 错在哪:指数模型换元后,把 z^=0.5x+0.5 当成最终答案。
为什么错:题目要的是 y 关于 x 的方程。
正确做法:y^=ez^=e0.5x+0.5。
- 错在哪:认为”R2 大就说明 x 导致 y“。
为什么错:R2 只说明拟合得好,和相关系数一样不说明因果。
正确做法:R2 只用来比较模型的拟合效果。
最小二乘法像在一堆点中间放一根尺子,转来转去,直到“每个点到尺子的竖直距离的平方加起来”最小。量的是竖直距离,因为我们用 x 预测 y,误差出在 y 上。用平方而不用绝对值,是因为平方可以展开、配方,能直接求出最小值,证明里那一步“交叉项消失”就是靠它。
直线一定穿过样本中心:上下的残差互相抵消,和为 0,就像跷跷板在中心处平衡。
- 前置:38.2 样本相关系数,先确认线性相关足够强再用直线拟合;R2=r2。
- 前置:第 4 章二次函数的最值,最小二乘法的推导就是两次配方。
- 前置:第 28 章直线的方程,经验回归方程就是点斜式,过 (xˉ,yˉ)、斜率 b^。
- 前置:第 8 章、第 9 章指数与对数,非线性回归用取对数换元。
- 前置:第 36 章随机变量的均值和方差,模型里的 E(e)=0、D(e)=σ2。
分类变量:取值是类别的变量,如性别(男、女)、是否近视(是、否)。用 X、Y 表示两个分类变量,各有两类,记作 X=0、X=1 和 Y=0、Y=1。
2×2 列联表:把 n 个对象按两个变量交叉分成四组,数出每组的个数:
|
Y=0 |
Y=1 |
合计 |
| X=0 |
a |
b |
a+b |
| X=1 |
c |
d |
c+d |
| 合计 |
a+c |
b+d |
n=a+b+c+d |
直观判断:比较两行里 Y=0 所占的比例 a+ba 和 c+dc。两者差得越多,越说明 X 和 Y 有关联。画成等高堆积条形图(每根柱子总高代表 100%,按比例分成两段)看得更清楚。
独立性检验:
- 提出零假设 H0:X 和 Y 相互独立(没有关联)。
- 计算
χ2=(a+b)(c+d)(a+c)(b+d)n(ad−bc)2.
- 按题目给的小概率值 α,查出临界值 xα,它满足:H0 成立时 P(χ2≥xα)=α。
- 下结论:
- χ2≥xα:推断 H0 不成立,即认为 X 和 Y 有关联,此推断犯错误的概率不大于 α;
- χ2<xα:没有充分证据推断 H0 不成立,可以认为 X 和 Y 独立。
这种检验叫“基于小概率值 α 的检验规则”。常用临界值(人教 A 版教材列出的五个):
| α |
0.1 |
0.05 |
0.01 |
0.005 |
0.001 |
| xα |
2.706 |
3.841 |
6.635 |
7.879 |
10.828 |
α 越小,要求越严,临界值越大。

- 给出列联表或等高堆积条形图,问两个变量“是否可能有关”:比较两行的比例,做直观判断。
- 给出列联表和小概率值 α,要求做独立性检验:写零假设、算 χ2、查临界值、按固定口径下结论。
- 题目用文字给出人数和比例,要自己整理列联表再检验:先把四个格子填全、核对合计,再算 χ2。
- 题目问样本量扩大或缩小后结论会不会变:比例不变时,χ2 和样本量成正比。
- 列联表里填的是人数(频数),不是百分比。题目给比例时先换成人数。
- 公式里 a、b、c、d 的位置要和表对应:ad 是主对角线,bc 是副对角线。行列整体交换不影响 χ2,因为 (ad−bc)2 和分母都不变。
- 结论有固定口径。“认为有关联”后面要跟“犯错误的概率不大于 α”;χ2<xα 时不能写“证明了两者无关”,只能写“没有充分证据推断 H0 不成立”。
- 同一个 χ2,在不同的 α 下结论可能不同。先看题目指定哪个 α。
- 独立性检验说的是“有没有关联”,不是因果,也不说明关联有多强。
- χ2 和临界值的比较依赖“样本量足够大”。统计学上一般要求每个格子的期望频数(见“证明”)不太小,高考题不考这一条。
χ2 的公式从哪里来。 如果 X 和 Y 独立,由第 21 章,P(X=0,Y=0)=P(X=0)P(Y=0)。用频率估计概率,左上格“应该有”的人数(叫期望频数)是
n⋅na+b⋅na+c=n(a+b)(a+c).
实际人数 a 和期望频数的差为
a−n(a+b)(a+c)=na(a+b+c+d)−(a+b)(a+c)=nad−bc.
(关键一步:分子展开后 a2、ab、ac 都消掉,只剩 ad−bc。另外三格同理,差分别是 −nad−bc、−nad−bc、nad−bc,四个差的绝对值都相同。)
所以 ad−bc 衡量“实际和独立时的期望差多远”。把四格的“差的平方除以期望频数”加起来:
χ2=四格∑期望(实际−期望)2=n2(ad−bc)2⋅n(a+b1+c+d1)(a+c1+b+d1).
括号里 a+b1+c+d1=(a+b)(c+d)n,a+c1+b+d1=(a+c)(b+d)n,代入化简就是
χ2=(a+b)(c+d)(a+c)(b+d)n(ad−bc)2.
为什么 χ2 大就否定独立。 H0 成立时,实际和期望只因抽样的偶然性而有差别,χ2 一般不大;χ2≥xα 的概率只有 α(如 0.05),是小概率事件。小概率原则:小概率事件在一次试验中几乎不会发生。现在它发生了,就有理由怀疑 H0。这样推断也可能错(H0 其实成立、只是碰巧 χ2 很大),但出错的概率不超过 α。
临界值从哪里来。 “H0 成立时 χ2 近似服从自由度为 1 的 χ2 分布”,临界值就是这个分布的上 α 分位数。这一点要用大学概率论的中心极限定理和 χ2 分布才能严格证明,高中直接用表。写作时用自由度 1 的 χ2 分布的尾概率公式 P(χ2≥x)=erfc(x/2) 逐个反算核对过表中五个临界值,都与教材一致。
例 1 (场景:由列联表直观判断)某校随机调查 200 名学生,按每天使用电子产品是否超过 2 小时、是否近视分类,得到下表。画等高堆积条形图,直观判断近视与使用时长是否有关。
|
近视 |
不近视 |
合计 |
| 超过 2 小时 |
60 |
40 |
100 |
| 不超过 2 小时 |
35 |
65 |
100 |
| 合计 |
95 |
105 |
200 |
解:超过 2 小时的学生中近视的比例为 10060=60%,不超过 2 小时的为 10035=35%。
两根柱子的分界线高低差得很明显,直观上近视与使用时长有关:使用时间长的学生近视比例更高。
容易卡在:直接比较 60 和 35 这两个人数。两行合计不相等时,人数没有可比性,要比较比例。本题两行都是 100 人才恰好一样。
例 2 (场景:完整的独立性检验)根据例 1 的数据,依据小概率值 α=0.001 的独立性检验,分析近视与每天使用电子产品是否超过 2 小时有没有关联。
解:零假设 H0:近视与每天使用电子产品是否超过 2 小时相互独立。
a=60,b=40,c=35,d=65,n=200。ad−bc=3900−1400=2500。
χ2=100×100×95×105200×25002=997500001250000000≈12.531.
查表 x0.001=10.828,12.531>10.828。
根据小概率值 α=0.001 的独立性检验,推断 H0 不成立,即认为近视与每天使用电子产品是否超过 2 小时有关联,此推断犯错误的概率不大于 0.001。
容易卡在:分母四个合计漏乘一个;结论漏掉“犯错误的概率不大于 0.001”。
例 3 (场景:由文字整理列联表再检验)某社区随机调查 100 名居民,其中 50 人参加了一年的健身打卡活动,这 50 人中有 30 人体检指标改善;未参加的 50 人中有 20 人体检指标改善。分别依据 α=0.05 和 α=0.01 的独立性检验,判断体检指标改善与是否参加活动有无关联。
解:先整理列联表:
|
改善 |
未改善 |
合计 |
| 参加 |
30 |
20 |
50 |
| 未参加 |
20 |
30 |
50 |
| 合计 |
50 |
50 |
100 |
零假设 H0:体检指标改善与是否参加活动相互独立。
χ2=50×50×50×50100×(30×30−20×20)2=6250000100×5002=4.
- α=0.05:x0.05=3.841,4>3.841。推断 H0 不成立,即认为体检指标改善与是否参加活动有关联,此推断犯错误的概率不大于 0.05。
- α=0.01:x0.01=6.635,4<6.635。没有充分证据推断 H0 不成立,可以认为体检指标改善与是否参加活动独立。
容易卡在:以为两个结论矛盾。α=0.01 的要求更严,证据(χ2=4)够过低的门槛、不够过高的门槛,所以结论不同。
例 4 (场景:样本量变化的影响)把例 3 的调查规模缩小一半,四个格子分别为 15、10、10、15,比例和例 3 完全相同。依据 α=0.05 的独立性检验,结论还一样吗?
解:
χ2=25×25×25×2550×(15×15−10×10)2=39062550×1252=2.
2<3.841,没有充分证据推断 H0 不成立,可以认为两者独立。结论和例 3 不同。
另一种解法:四个格子都乘 k 时,n 乘 k,(ad−bc)2 乘 k4,分母乘 k4,所以 χ2 乘 k。这里 k=21,χ2=4×21=2,不用重算。选择题、填空题问“扩大几倍后结论如何”时用这个结论最快;格子不是按同一倍数变化时,只能重算。
容易卡在:以为比例一样结论就一样。样本小的时候,同样的比例差可能只是偶然,证据不够。
- χ2=0⟺ad=bc⟺ 两行比例相同:a+ba=c+dc⟺a(c+d)=c(a+b)⟺ad=bc。所以 ∣ad−bc∣ 越大,两行的比例差得越多。
- 四格同乘 k,χ2 也乘 k:推导见例 4 的另一种解法。
- 期望频数:某格的期望频数 = 该行合计 × 该列合计 ÷n,推导见本节“证明”。
- 实际频数与期望频数之差的绝对值四格相同,都是 n∣ad−bc∣,推导见本节“证明”。
- 错在哪:χ2<xα 时写“所以两个变量一定无关”或“证明了两者独立”。
为什么错:没能否定 H0,不等于证明了 H0,只是证据不足。
正确做法:写“没有充分证据推断 H0 不成立,可以认为 X 和 Y 独立”。
- 错在哪:结论写“有 95% 的把握认为有关”之后,又写“犯错误的概率是 0.05”。
为什么错:α 是犯错误概率的上限,不是确切值。
正确做法:写“犯错误的概率不大于 0.05”。
- 错在哪:题目给的是百分比,直接把百分比代入 a、b、c、d。
为什么错:χ2 和样本量有关,必须用人数,百分比代入相当于把样本量改成了 100。
正确做法:先用比例乘各组人数,换成频数再代入。
- 错在哪:用 α=0.05 时查成 x0.05=2.706。
为什么错:2.706 是 α=0.1 的临界值。
正确做法:α 越小临界值越大,0.05 对应 3.841,0.01 对应 6.635。
独立性检验像法庭上的“无罪推定”:先假定两个变量无关(H0),再看证据。χ2 是证据的分量,临界值是定罪的门槛。证据超过门槛就“认为有关联”,并承认有不超过 α 的可能是冤枉了;证据不够就“不能认为有关联”,但这不等于证明了清白。α 越小,门槛越高,越难定罪,也越不容易冤枉。
ad−bc 可以这样看:a、d 是“同向”的两格(如“时间长且近视”“时间短且不近视”),b、c 是“反向”的两格。同向的多、反向的少,ad 远大于 bc,说明两个变量一起变。
- 前置:第 21 章事件的独立性,H0 就是 P(AB)=P(A)P(B),期望频数由它算出。
- 前置:第 35 章条件概率,a+ba 是“在 X=0 的条件下 Y=0“的频率,比较两行比例就是比较两个条件概率的估计。
- 常一起考:第 36 章离散型随机变量,解答题常是“第一问独立性检验,第二问从表中抽人求分布列和均值”。
- 后续:大学统计学里的 χ2 检验和假设检验,高中的临界值表就是自由度为 1 的 χ2 分布表。
本章研究两个变量之间的关系,按变量的类型分成两条线。
两个变量都是数值时:先画散点图、算样本相关系数 r(38.2),确认大致呈直线、线性相关够强;再用最小二乘法求经验回归方程(38.3),用残差和 R2 检查拟合得好不好;散点呈曲线时换元化成直线。r 和回归之间有两条纽带:b^ 与 r 同号,一元线性回归中 R2=r2。
两个变量都是类别时:排成 2×2 列联表,先比较比例做直观判断,再用 χ2 做独立性检验(38.4)。它的零假设”X 与 Y 独立“就是第 21 章的事件独立性。

考试里两条线都会出解答题,而且常和第 36 章的分布列组合:回归题的第二问常是“用方程预测后再算概率”,独立性检验题的第二问常是“从表中按分层抽样抽人,求分布列和均值”。
- 四组成对数据的样本相关系数分别为 r1=0.92,r2=−0.95,r3=0.31,r4=−0.08。哪一组的线性相关最强?
- 若所有样本点都在直线 y=−3x+2 上,样本相关系数 r 是多少?
- 已知 xˉ=4,yˉ=10,b^=1.5,求经验回归方程,并求 x=10 时的预测值。
- 经验回归方程为 y^=2x+1,样本点 (3,8) 的残差是多少?
- 2×2 列联表中 a=40,b=10,c=30,d=20。求 χ2(保留三位小数),并写出依据 α=0.05 的独立性检验能否认为两个变量有关联。
- 例 3 的四个格子都扩大到原来的 2 倍(60、40、40、60),χ2 是多少?依据 α=0.005 的独立性检验能否认为有关联?
答案:1. 第二组;2. −1;3. y^=1.5x+4,预测值 19;4. 1;5. χ2≈4.762>3.841,能认为有关联,犯错误的概率不大于 0.05;6. χ2=8>7.879,能认为有关联,犯错误的概率不大于 0.005。